Frontier-Reasoning, Codegenerierung, Long-Context-Analyse und agentische Workflows über eine souveräne API, gehostet in Frankreich. Keine Datenspeicherung. Kein Kompromiss.
Sehen Sie unsere Keynote und erfahren Sie, wie die IG1 AI API Weltklasse-KI-Performance mit vollständiger Datensouveränität liefert — bei bis zu 3× geringeren Kosten.
Die offiziellen Benchmarks von GLM 5.3 Flash zeigen führendes agentisches Coding, langfristige Terminal-Ausführung, ein Kontextfenster von einer Million Tokens und native multimodale Eingabe.
Terminal-Bench 2.1
84,3Agentischer Benchmark
GLM 5.3 Flash erreicht in der offiziellen Benchmark-Tabelle von Z.ai 84,3 auf Terminal-Bench 2.1 und liegt damit bei der agentischen Terminal-Ausführung auf dem Niveau der stärksten proprietären Modelle.
—Agentisches Coding und Terminal-Ausführung
—320B-MoE-Architektur, 18B aktive Parameter
—Keine Datenspeicherung, vollständig souverän
—Frontier-Reasoning über die IG1 AI API
Kontextfenster
1MTokens
GLM 5.3 Flash unterstützt offiziell ein Kontextfenster von einer Million Tokens und bis zu 128K Ausgabe-Tokens und eignet sich damit für lange Dokumente, große Codebasen und mehrstufige Agenten-Workflows.
—Offizielle Kontextlänge von 1M Tokens
—Bis zu 128K Ausgabe-Tokens
—Hybride Sparse- und lineare Attention
Nativ multimodal
320BParameter — 18B aktiv
GLM 5.3 Flash ist das erste nativ multimodale Modell der GLM-5-Reihe: Video-, Bild-, Text- und Datei-Eingabe in einer Sparse-MoE-Architektur mit 18 Milliarden aktiven Parametern.
—Video-, Bild-, Text- und Datei-Eingabe
—3,01× weniger Attention-Rechenaufwand als GLM-5.3
—4,44× kleinerer KV-Cache als GLM-5.3
—Offene Gewichte unter MIT-Lizenz
Effizientes Frontier-Modell
GLM 5.3 Flash. Das Flaggschiff.
GLM 5.3 Flash ist das effiziente Frontier-Modell der IG1 AI API: eine nativ multimodale Engine für Reasoning, Coding und agentische Ausführung mit einem Kontextfenster von einer Million Tokens, bereitgestellt mit souveräner Inferenz und transparenter Preisgestaltung pro Token.
Modell
Positionierung
Ideal für
Von IG1 AI angeboten
Kleines Modell
Kompakt
Einfache Automatisierung
✓ Qwen 3.8 27B
Mittelgroßes Modell
Ausgewogen
Schnelle Enterprise-Workloads
✓ Qwen 3.8 Flash Next
Effizientes Frontier-Modell
Effizient
Weltklasse-Reasoning, Code und Agenten
✓ GLM 5.3 Flash
Was GLM 5.3 Flash in der Praxis verändert
GLM 5.3 Flash ist für Aufgaben gebaut, bei denen Qualität, Präzision und Ausdauer mehr zählen als eine schnelle Standardantwort. Hier zeigt sich der Unterschied sofort:
Analyse langer Verträge
GLM 5.3 Flash verfolgt Querverweise, verschachtelte Klauseln, Ausnahmen und Definitionen über sehr lange Dokumente hinweg — bis zu einer Million Tokens Kontext — und verarbeitet neben Text auch gescannte Seiten und Bilder.
Codegenerierung über mehrere Dateien
Von der Architekturplanung bis zu Implementierungsdetails ist GLM 5.3 Flash auf kohärente Entwicklung über mehrere Dateien, Refactoring, Debugging und Terminal-Ausführung ausgelegt — mit 84,3 auf Terminal-Bench 2.1.
Reasoning unter mehreren Randbedingungen
Budget, Zeitplan, Stack, Compliance, Sicherheit, UX, Skalierbarkeit: GLM 5.3 Flash hält gleichzeitige Randbedingungen präsent und übersetzt sie in klare Entscheidungen.
Komplexe Anweisungen über langen Kontext
Bei langen Prompts mit verschachtelten Anforderungen ist GLM 5.3 Flash das Modell der Wahl, wenn die Antwort bis zum Ende der Generierung jeder Anweisung treu bleiben muss.
Warum GLM 5.3 Flash wählen?
Setzen Sie GLM 5.3 Flash ein, wenn die Aufgabe strategisch ist: anspruchsvolles Reasoning, Produktideen, fortgeschrittenes Coding, agentische Planung, tiefgehende Analysen sowie Dokumente und Medien, bei denen kleine Fehler teuer werden. Zugleich ist es das günstigste Modell im IG1-AI-Katalog – die Standardwahl auch für die tägliche Arbeit.
Frontier-Leistung zum niedrigsten Token-Preis
GLM 5.3 Flash ist das Flaggschiff des Katalogs – und zugleich das günstigste Modell: 0,40 € / 1 Mio. Input-Tokens (0,09 € gecacht) und 1,30 € / 1 Mio. Output-Tokens. Qwen 3.8 Flash Next, Qwen 3.8 27B und Qwen 3.5 122B-A10B ergänzen den Katalog für Produktions-Workloads, alle drei zu 0,60 € / 2,50 €.
Mittelgroßes Modell
Qwen 3.8 Flash Next. Mittelklasse-Leistung, bereit für die Produktion.
GLM 5.3 Flash ist das Flaggschiff. Qwen 3.8 Flash Next ist die mittlere Stufe: ein Modell mit neuer Architektur für Produktivlast — mit Qwen 3.8 27B in der kompakten Stufe und Qwen 3.5 122B-A10B für eine größere Wissensbasis, alle drei zum exakt selben Preis.
Mittelgroßes Modell der neuen Generation
Qwen 3.8 Flash Next ist die jüngste Generation der Qwen-Familie: ein mittelgroßes Modell mit spärlicher Aktivierung, das weniger als 5 % seiner Parameter je Token nutzt — Mittelklasse-Leistung mit dem Inferenz-Fußabdruck eines kompakten Modells.
Für Produktivlast gebaut
Mit 0,60 € Input und 2,50 € Output je 1 Mio. Tokens ist Qwen 3.8 Flash Next für Produktivlast, interne Copiloten und Agenten-Pipelines mit hohem Volumen gemacht.
Produktionsreife Vielseitigkeit
Nutzen Sie es für Chat, Coding-Unterstützung, OCR-/Vision-Workflows, strukturierte Extraktion, Zusammenfassungen und werkzeugnutzende Agenten, wenn Reasoning auf Frontier-Niveau nicht erforderlich ist.
Drei Modelle, ein Preis
Qwen 3.8 27B und Qwen 3.5 122B-A10B bleiben zum exakt selben Tarif von 0,60 € / 2,50 € verfügbar: Wechseln Sie zum kompakten Dense-Modell oder zur größeren Mixture-of-Experts-Wissensbasis, wann immer eine Workload es erfordert — ohne Budgetauswirkung.
Neu
Qwen 3.8 Flash Next: eine neuartige Architektur
September 2026
Qwen 3.8 Flash Next ist die öffentliche Vorschau auf die Qwen4-Architektur. Wo fast alle LLM weiterhin auf dichte Attention und einen mit dem Kontext wachsenden Cache setzen, baut er vier Ebenen zugleich um: Attention, Residual, Embeddings und Optimierer.
Hybride Attention im Verhältnis 3:1
Drei Gated-DeltaNet-Schichten auf eine Qwen-Sparse-Attention-Schicht, zwölfmal über 48 Schichten wiederholt. Gated DeltaNet komprimiert den Verlauf, statt ihn vollständig zu behalten; Qwen Sparse Attention wählt über einen leichtgewichtigen Indexer nur den relevanten Kontext aus, auf Mikroblock-Ebene. Daher die Gewinne bei sehr langem Kontext.
Sparsity bis ans Limit
512 Experten, davon 10 geroutet und 1 geteilt pro Token: 6 Milliarden aktive Parameter von 125 Milliarden, weniger als 5 % des Modells im Einsatz. Die höchste Sparsity im IG1-Katalog, vor GLM 5.3 Flash (5,6 %) und Qwen 3.5 122B-A10B (8,2 %).
Auslagerbare N-Gramm-Embeddings
Weitere 51 Milliarden Parameter in einer Tabelle, die außerhalb des Rechenpfads liegt und aus dem GPU-Speicher ausgelagert werden kann: Die Modellkapazität wächst ohne proportionale Inferenzkosten.
Ein anderes Trainingsrezept
Ein Gated Residual mit vier Zweigen für die Stabilität bei dieser Sparsity und der Muon-Optimierer statt AdamW. Alibaba nennt Trainingskosten von einem Neuntel gegenüber Qwen3.7-Plus.
Schnelle Enterprise-Workloads, sehr langer Kontext
Qwen 3.8 Flash Next
Mittlere Stufe, bis zu 1 Mio. Tokens, gleicher Preis
Produktiv-Chat, Extraktion, Copiloten, Agenten mit hohem Volumen
Qwen 3.8 27B
Kompaktes Dense-Modell für hohe Volumen
Breites Wissen, lange Dokumente, multimodale Workflows
Qwen 3.5 122B-A10B
Größere Wissensbasis, gleicher Preis
Hybrides Routing
GLM + Qwen
GLM als Standard, Qwen wo sein Profil passt
Anwendungsfälle
Was bedeutet das für Ihr Team?
Jeder in Ihrem Team kann KI nutzen — nicht nur Ihre Ingenieure. Marketing, Vertrieb, Analysten, Entwickler. Die IG1 AI API holt Sie dort ab, wo Sie stehen.
Chat
Binden Sie dialogfähige KI in jede Anwendung ein. Bauen Sie intelligente Assistenten, Support-Bots und interaktive Workflows.
Code
Liefern Sie Features schneller mit KI-gestützter Entwicklung. Code generieren, prüfen, refaktorieren und debuggen — im Enterprise-Maßstab.
Zusammenfassen
Verwandeln Sie Tausende Dokumente in umsetzbare Erkenntnisse. Unternehmenswissen extrahieren, verdichten und im großen Maßstab analysieren.
Erstellen
Erzeugen Sie Inhalte und Analysen im großen Maßstab. Von Marketingtexten bis zu Finanzberichten — KI-gestützte Erstellung für jede Abteilung.
Kundenstimme
EasyBourse: Softwareentwicklung skalieren mit souveräner KI.
FINANZEN · SOFTWAREENTWICKLUNG
Ein gefilmtes Kundenstatement: EasyBourse berichtet, wie souveräne KI seinen Teams hilft, die Softwareentwicklung zu skalieren.
Die Frage, die jedes Unternehmen stellt. Genau dafür ist die IG1 AI API gebaut. Ihr Security-Team sagt Ja. Ihre Rechtsabteilung sagt Ja. Und Sie können sicher und schnell vorangehen.
Keine Datenspeicherung
Ihre Prompts werden verarbeitet und sofort gelöscht. Nichts wird gespeichert, nichts protokolliert.
Kein Modelltraining
Wir verwenden Ihre Daten niemals zum Training von Modellen. Ihr geistiges Eigentum gehört Ihnen.
100 % souverän
Ihre Daten verlassen die Grenzen Ihres Unternehmens nie. Vollständig konform mit DSGVO, EU AI Act und ISO 27001.
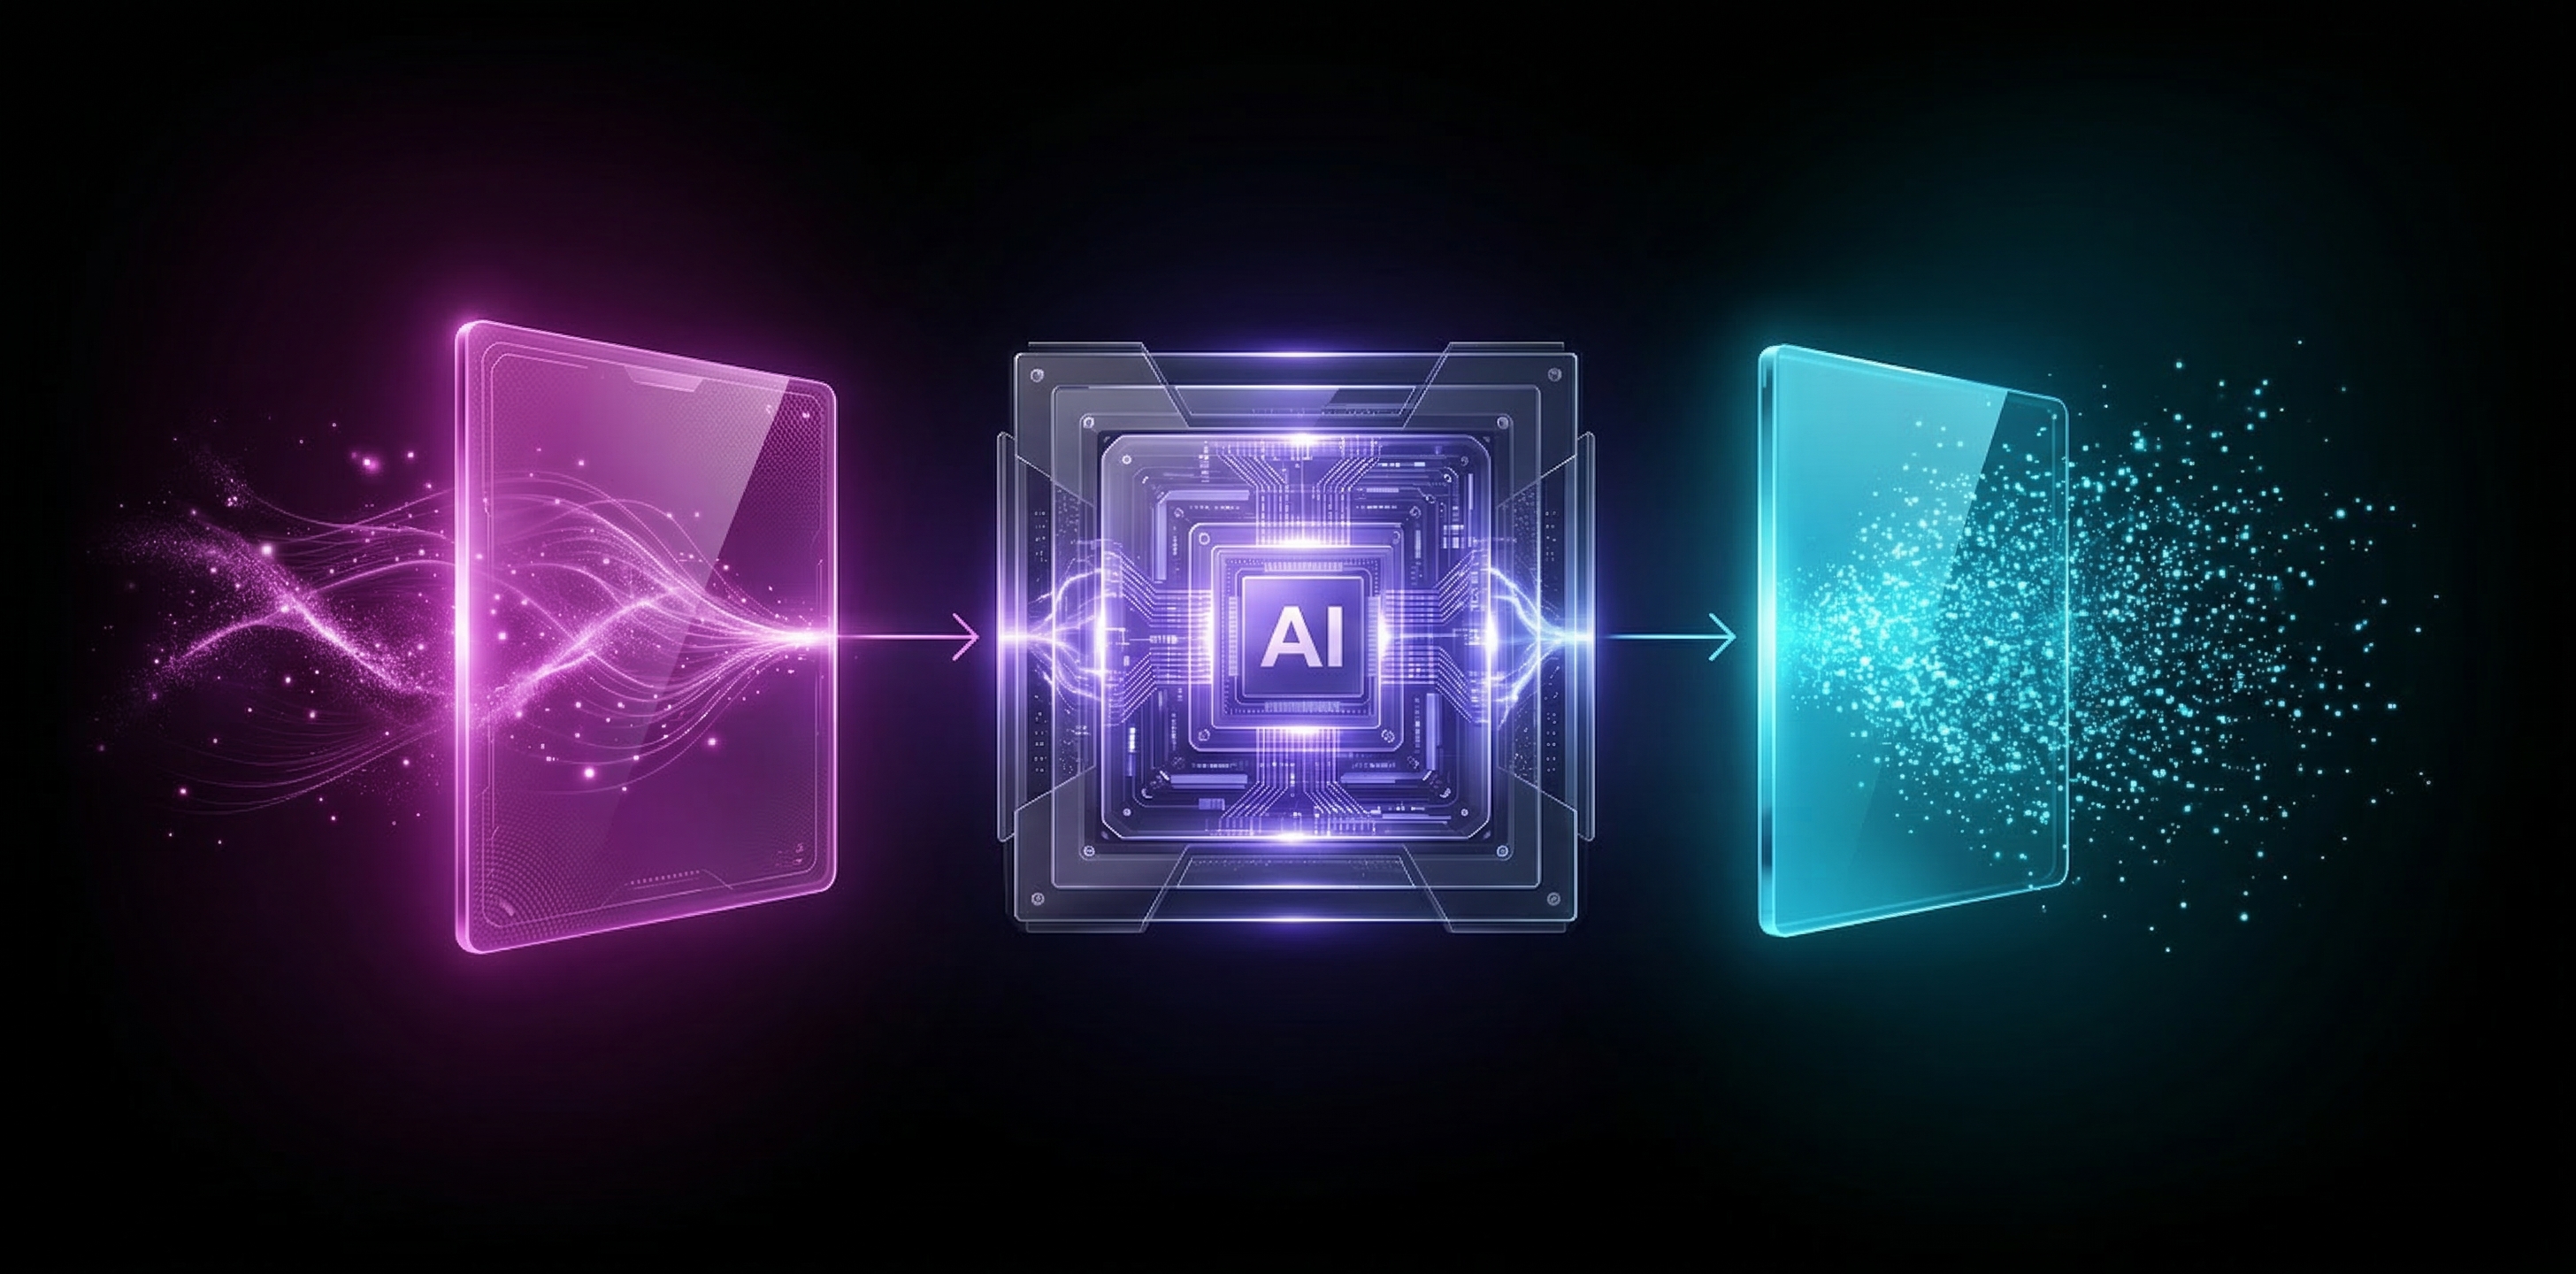
Ihr Prompt
IG1 AI verarbeitet
Sofort gelöscht
Keine Logs • Keine Speicherung • Kein Training
Fortgeschrittene Fähigkeiten
Nicht nur Compliance. Echte Leistungsfähigkeit.
Die IG1 AI API geht weiter. Enterprise-KI, gebaut für Ihre Arbeitsweise.
Erweitertes Denken
Komplexes, mehrstufiges Reasoning für anspruchsvolle Problemlösungen. Chain-of-Thought-Verarbeitung für nuancierte Unternehmensszenarien — auf Basis des effizienten Frontier-Modells GLM 5.3 Flash, dort wo kleinere Modelle über lange Argumentationsketten die Kohärenz verlieren. Tiefes Reasoning, volle Souveränität, keine Datenspeicherung.
Websuche & Werkzeugnutzung
Integrierte Echtzeit-Websuche und vernetzte Workflows. Lassen Sie Ihre KI-Agenten mit externen Werkzeugen und Datenquellen interagieren.
Sichere Computernutzung
Codeausführung und sichere Computernutzung für echte agentische Automatisierung. Lassen Sie KI gefahrlos in Sandbox-Umgebungen arbeiten.
Open-Weight-Modelle
Angetrieben von den besten offenen Modellen.
Wir setzen auf die leistungsstärksten heute verfügbaren Open-Weight-Modelle. Keine Anbieterabhängigkeit. Volle Transparenz.
GLM 5.3 Flash Frontier
von Z.ai — Peking, China
Effizientes Frontier-LLM
Das Flaggschiff unseres Katalogs für Reasoning, Code und agentische Workflows – und sein niedrigster Token-Preis.
Qwen 3.5
von Alibaba Cloud — Hangzhou, China
122B-A10B-LLM
Effizientes Hochleistungsmodell für Produktiv-Chat, Code, Reasoning und mehrstufige Dialoge.
Qwen Image
von Alibaba Cloud — Hangzhou, China
Vision & Multimodalität
Bildverständnis, visuelle Analyse und multimodales Reasoning für Unternehmens-Workflows.
Qwen3-VL-Embedding-8B SOTA
von Alibaba Cloud — Hangzhou, China
Multimodales Embedding
Modernstes Retrieval mit multimodalen Embeddings und dynamischen Dimensionen bis 4096 — weit über Textencoder mit fester Größe hinaus.
BGE
von BAAI — Peking, China
Schnelles Embedding & Reranking
Schnelle Text-Embeddings mit fester Dimension und Reranking — eine Qualitätsreferenz für semantische Suche und RAG-Pipelines mit hohem Durchsatz.
Verfügbar ab September 2026
Zwei Modelle kommen auf unsere souveräne Infrastruktur: Sie decken die kompakte und die mittlere Stufe ab.
Qwen 3.8 Flash Next September 2026
von Alibaba Cloud — Hangzhou, China
Mittelgroßes LLM
Die nächste mittlere Größenklasse, die Qwen 3.5 122B-A10B für Produktiv-Chat, Code und mehrstufige Dialoge ablösen wird.
Qwen 3.8 27B September 2026
von Alibaba Cloud — Hangzhou, China
Dichtes 27B-LLM
Kompaktes dichtes Modell der neuesten Generation für Produktiv-Chat, Code, Extraktion und mehrstufige Dialoge.
Modellpreise
Unsere Modelle
Transparente Preise pro Token. Alle Modelle sind souverän, in Frankreich gehostet, ohne versteckte Gebühren und ohne Mindestabnahme.
Sprachmodelle
Modell
Beschreibung
1 Mio. Input-Tokens
1 Mio. Output-Tokens
GLM-5.3-FlashSeptember 2026
Nativ multimodales effizientes Frontier-Modell (Video, Bild, Text, Datei) für Reasoning, Code und agentische Workflows. Max. Kontext: 1M Tokens, 128K Ausgabe.
0,40 €Gecachter Input: 0,09 €
1,30 €
Qwen3.5-122B-A10B
Effizientes Hochleistungsmodell für Produktiv-Chat, Code und Reasoning. Standard-Instruct-Profil.
0,60 €
2,50 €
Qwen3.5-122B-A10B Creative
Wie Qwen3.5-122B-A10B, mit Hyperparametern für kreative Ideenfindung, Synthese und hochwertige Inhaltserstellung.
0,60 €
2,50 €
Qwen3.5-122B-A10B Thinking
Wie Qwen3.5-122B-A10B, mit erzwungenem Thinking-Modus für strukturiertes Reasoning und Analyse. Max. Kontext: 256K Tokens.
0,60 €
2,50 €
Qwen3.5-122B-A10B Thinking Coder
Qwen3.5-122B-A10B, konfiguriert für fortgeschrittenes Coding, Architektur, Refactoring, Debugging und Entwicklungs-Workflows mit erzwungenem Thinking.
0,60 €
2,50 €
Qwen3.8-Flash-NextSeptember 2026
Nächste mittlere Größenklasse, die Qwen3.5-122B-A10B für Produktiv-Chat, Code und mehrstufige Dialoge ablösen wird.
0,60 €
2,50 €
Qwen3.8-27BSeptember 2026
Kompaktes Modell der neuesten Generation für Produktiv-Chat, Code, Extraktion und mehrstufige Dialoge. Standard-Instruct-Profil.
0,60 €
2,50 €
Qwen3.8-27B CreativeSeptember 2026
Wie Qwen3.8-27B, mit Hyperparametern für kreative Ideenfindung, Synthese und hochwertige Content-Generierung.
0,60 €
2,50 €
Qwen3.8-27B ThinkingSeptember 2026
Wie Qwen3.8-27B mit erzwungenem Thinking für strukturiertes Reasoning und Analyse.
0,60 €
2,50 €
Qwen3.8-27B Thinking CoderSeptember 2026
Qwen3.8-27B, konfiguriert für fortgeschrittenes Coding, Refactoring, Debugging und Entwicklungs-Workflows mit erzwungenem Thinking.
0,60 €
2,50 €
BGE-m3
Text-Embeddings für RAG und semantische Suche.
0,05 €
—
BGE-reranker-v2-m3
Reranking zur Optimierung von Suchergebnissen.
0,30 €
—
Dokument
Wandelt beliebige Dokumente in Markdown um, damit ein LLM sie nutzen kann. Nützlich für CAG – Cached RAG einschließlich Vision-RAG-Anwendungsfällen. Dokumentbilder werden nach IG1-Standard als Text beschrieben.
—
2,00 €
Bildmodelle
Modell
Beschreibung
1 Mio. Input-Tokens
1 Mio. Output-Tokens
Qwen Image
Bildgenerierung. Die Token-Zahl richtet sich nach Bildauflösung und Qualitätsstufe.
0,60 €
2,50 €
Qwen Image PE
Bildgenerierung mit Prompt-Optimierung durch ein LLM. Die Prompt-Optimierung nutzt Qwen3.5-122B-A10B (separat abgerechnet). Die Token-Zahl richtet sich nach Auflösung und Qualitätsstufe.
0,60 €
2,50 €
Qwen Image Edit
Bildbearbeitung. Die Token-Zahl richtet sich nach Auflösung und Qualitätsstufe von Quell- und Zielbild.
0,60 €
2,50 €
Qwen Image Edit PE
Bildbearbeitung mit Prompt-Optimierung durch ein LLM. Die Prompt-Optimierung nutzt Qwen3.5-122B-A10B (separat abgerechnet). Die Token-Zahl richtet sich nach Auflösung und Qualität von Quell- und Zielbild.
0,60 €
2,50 €
Preise
Weltklasse-Performance. 3× geringere Kosten.
Bis zu 3× günstiger als US-Hyperscaler. Mit der IG1 AI API muss keine Infrastruktur aufgebaut werden. Anwendungen verbinden sich sofort, und die Einsparungen beginnen ab Tag eins.
Alles Wissenswerte zur IG1 AI API — Souveränität, Modelle, Preise und Einstieg.
Souveränität & Sicherheit
Wo werden meine Daten gehostet?
Ausschließlich in eigenen Rechenzentren von IG1 in Frankreich, auf Hardware von Dell Technologies und NVIDIA. Ihre Daten verlassen unsere europäische Infrastruktur nie.
Speichern oder verwenden Sie meine Daten zum Modelltraining?
Nein. Keine Datenspeicherung. Kein Training mit Daten. Keine Datenweitergabe. Sobald Ihre Anfrage verarbeitet ist, ist sie weg. Punkt.
Ist IG1 AI DSGVO-konform?
Ja. Ebenso mit ISO 27001 und dem EU AI Act. Unsere souveräne, in der EU gehostete Architektur mit strikter Zusicherung der Nichtspeicherung ist auf Compliance by Default ausgelegt.
Worin unterscheidet sich das von ChatGPT, Claude oder Gemini?
OpenAI, Anthropic und Google sind US-Unternehmen und unterliegen US-Recht (einschließlich CLOUD Act). Ihre Daten laufen über US-Infrastruktur und können dort gespeichert werden. Bei IG1 AI bleiben Ihre Daten in Frankreich, unter europäischem Recht — ohne Speicherung, ohne Weitergabe, ohne Training.
Modelle & Performance
Welche Modelle setzt IG1 AI ein?
Wir betreiben die besten verfügbaren Open-Weight-Modelle, angeführt von GLM 5.3 Flash für Frontier-Reasoning, Coding und agentische Workflows. Der Katalog umfasst außerdem Qwen3.5-122B-A10B und Qwen3.8-27B für effiziente Hochleistungs-Sprachaufgaben, Qwen3-VL-Embedding-8B und BGE für Embeddings und Reranking sowie Qwen Image für die Bildgenerierung.
Kann ich wählen, welches Modell genutzt wird?
Ja. Wählen Sie GLM 5.3 Flash – das leistungsstärkste und zugleich günstigste Modell im Katalog – für Frontier-Reasoning und -Coding, Qwen3.5-122B-A10B oder Qwen3.8-27B für Produktiv-Workloads, die zu ihrem Profil passen, oder die spezialisierten Embedding- und Reranking-Modelle Qwen3-VL-Embedding-8B / BGE sowie Qwen Image für besondere Aufgaben.
Sind Ihre Modelle quantisiert?
Ja — bewusst und so gewählt, dass die Qualität erhalten bleibt. Wo eine Version mit höherer Präzision existiert (z. B. bei Qwen), liefern wir FP8 aus: Der Qualitätsverlust ist vernachlässigbar, während GPU-Speicher und Kosten etwa halbiert werden — der richtige technische Kompromiss. Erscheint ein Frontier-Modell ausschließlich quantisiert, liefern wir es in seiner nativen Präzision aus. Was wir nie tun: aggressive Low-Bit-Quantisierung, die die schwierigsten Aufgaben verschlechtern würde (mehrstufiges Reasoning, komplexe Dokumentenanalyse, umfangreiche Codegenerierung). Die von uns veröffentlichten Benchmarkwerte entsprechen genau der Präzision, die wir im Produktivbetrieb ausliefern.
Preise & Abrechnung
Wie funktioniert die Preisgestaltung?
Zwei Bestandteile. Ein pauschales Abonnement zu 100 € / Monat, das 100 € Nutzung über alle Modelle des Katalogs einschließt. Darüber hinaus wird die Nutzung zu den veröffentlichten Token-Preisen abgerechnet (GLM 5.3 Flash zu 0,40 € Input, 0,09 € gecachtem Input und 1,30 € Output; Qwen3.5-122B-A10B und Qwen3.8-27B zu 0,60 € / 2,50 €), bis zu einer monatlichen Obergrenze von 1 000 € beim Abonnement zu 100 € (die Obergrenze passt sich Ihrem Tarif an). Keine versteckten Gebühren.
Was passiert, wenn ich meine Obergrenze erreiche?
Ihre monatliche Obergrenze liegt beim Abonnement zu 100 € bei 1 000 € und steigt mit höheren Tarifen. Ist sie erreicht, pausiert der Zugang bis zum nächsten Abrechnungszeitraum — oder bis Sie diesen Betrag begleichen. Über die von Ihnen gesetzte Obergrenze hinaus wird Ihnen nie etwas berechnet. Wenn Sie sie regelmäßig erreichen, sprechen wir über eine Anhebung Ihres Limits.
Wie wird der Mehrverbrauch abgerechnet?
Am 1. jedes Monats rechnen wir den Mehrverbrauch des Vormonats — also die Nutzung über Ihr enthaltenes Kontingent hinaus — gemeinsam mit dem Abonnement für den kommenden Monat ab. Die Zahlung erfolgt per SEPA-Lastschrift oder hinterlegter Karte.
Warum ein Abonnement plus nutzungsbasierte Abrechnung?
Sie erhalten die Planbarkeit einer festen monatlichen Basis und die Flexibilität, bei Bedarf zu skalieren — ohne Nachverhandlung. Ruhige Monate bleiben günstig, intensive Monate bleiben gedeckelt. Sie zahlen nur, was Sie nutzen — bis zu einer Obergrenze, die Sie selbst festlegen.
Kann ich einen höheren Tarif buchen?
Ja. Für Teams mit höherem Bedarf gibt es höhere monatliche Abostufen — mit größerem enthaltenem Kontingent und höherer Obergrenze. Sprechen Sie mit dem Vertrieb, um eine zu Ihrem Volumen passende Vereinbarung zu treffen.
Gibt es eine kostenlose Testphase?
Sprechen Sie uns auf Optionen für ein Pilotprogramm an.
Einstieg
Wie lange dauert die Einrichtung?
Auf Ihrer Seite ist keinerlei Infrastruktur einzurichten. Sie können noch am selben Tag live gehen.
Brauche ich ein technisches Team, um IG1 AI zu nutzen?
Nein. IG1 AI ist für jedes Team gemacht — Marketing, Vertrieb, HR, Recht, Analyse und Entwicklung. Wer eine Chat-Oberfläche bedienen kann, kann IG1 AI nutzen.
Kann ich IG1 AI in meine bestehenden Tools integrieren?
Ja. IG1 AI bietet API-Zugang, kompatibel mit gängigen KI-Chat-Anwendungen (Msty, Open WebUI) und IDE-Integrationen für Entwickler. Binden Sie Ihre bestehenden Workflows an, ohne Ihre Werkzeuge zu wechseln.
Was, wenn eine bessere KI-Plattform erscheint?
Keine Bindung. Monatliche Abrechnung ohne Mindestlaufzeit bedeutet: Sie können jederzeit gehen. Da wir jedoch laufend auf die besten Open-Weight-Modelle aktualisieren, sind Sie ohne Wechsel immer an der Spitze.
TECHNOLOGIEPARTNER
Getragen von Branchenführern
Wir arbeiten mit den weltweit führenden Technologieanbietern zusammen, um souveräne KI-Infrastruktur in Enterprise-Qualität bereitzustellen.
NVIDIA
GPU-Infrastrukturpartner für unsere KI-Inferenz- und Trainings-Workloads. NVIDIA Accelerated Computing ermöglicht Echtzeit-Model-Serving mit unerreichter Performance.
Dell Technologies
Partner für Enterprise-Server und -Storage, der das On-Premise-Hardware-Rückgrat für souveräne KI-Deployments liefert — sicher, skalierbar und für den Produktivbetrieb gebaut.