API DE IA SOBERANA — ALOJADA EN FRANCIA, CERO RETENCIÓN DE DATOS
API de IA Soberana. Modelos de Frontera. Cero Fuga de Datos.
Razonamiento de frontera, generación de código, análisis de contexto largo y flujos de trabajo agénticos a través de una API soberana alojada en Francia. Cero retención de datos. Sin compromisos.
Mira nuestra presentación keynote para descubrir cómo IG1 AI API ofrece un rendimiento de IA de clase mundial con plena soberanía de los datos — con un coste hasta 3 veces menor.
Resultados oficiales de benchmarks, comparados con modelos de frontera en los mismos benchmarks: DeepSeek V4.1 Flash obtiene la puntuación más alta de la tabla comparativa de DeepSeek en DeepSWE v1.1, Automation-Bench v1.0.6 y Apex Bench v1.1.
DeepSWE v1.1
77,0benchmark de ingeniería de software
DeepSeek V4.1 Flash obtiene 77,0 en DeepSWE v1.1: la puntuación más alta de la tabla comparativa de DeepSeek, por delante de Claude Opus 5 (74,0) y GPT-5.6 Sol (73,0).
—Ingeniería de software multiarchivo autónoma
—Arquitectura MoE de 552.000 millones, 8.000/16.000 millones de parámetros activos
—Sin retención de datos, totalmente soberano
—Servido en Francia a través de la API de IG1 AI
Automation-Bench v1.0.6
60,5benchmark de automatización
DeepSeek V4.1 Flash obtiene 60,5 en Automation-Bench v1.0.6: la puntuación más alta de la tabla comparativa de DeepSeek, por delante de Claude Opus 5 (50,3).
—Puntuación más alta de la comparativa
—Diseñado para agentes de largo horizonte
—Contexto de 1M de tokens
Apex Bench v1.1
72,1benchmark de agentes y código
DeepSeek V4.1 Flash obtiene 72,1 en Apex Bench v1.1: la puntuación más alta de la tabla comparativa de DeepSeek, por delante de Claude Opus 5 (65,8) y GPT-5.6 Sol (54,3).
—Puntuación más alta de la comparativa
—Entrada nativa de texto e imagen
—Pesos abiertos con licencia MIT
Puntuaciones de la ficha oficial del modelo de DeepSeek (V4.1-Flash-1017, octubre de 2026), comparadas con modelos de frontera en los mismos benchmarks.
Modelo insignia
DeepSeek V4.1 Flash. Alojado en Francia.
El modelo open-weight de frontera de DeepSeek — un mixture-of-experts de 552.000 millones de parámetros, con 8.000 millones activos en prefill y 16.000 millones en decode, un contexto de un millón de tokens y comprensión nativa de texto e imagen. IG1 AI lo sirve en Francia, sin retención de datos y con precios transparentes por token.
Mejor modelo open-weight para código
77,0 en DeepSWE v1.1 en ingeniería de software autónoma: por delante de Claude Opus 5 (74,0) y GPT-5.6 Sol (73,0).
Líder en automatización
La puntuación más alta de la tabla comparativa de DeepSeek en Automation-Bench v1.0.6 (60,5) y en Apex Bench v1.1 (72,1).
Diseñado para agentes de largo horizonte
Un contexto de un millón de tokens para programación multiarchivo, razonamiento profundo y agentes que funcionan durante horas.
Tus datos se quedan en Francia
Inferencia en la infraestructura certificada HDS de IG1 en Francia: cero retención de datos, ningún entrenamiento de modelos con tus prompts, facturación en euros y sin exposición a la jurisdicción estadounidense.
Inferencia soberana, en Francia.
DeepSeek V4.1 Flash es un modelo de pesos abiertos (MIT) disponible en muchos proveedores de todo el mundo. Lo que aporta IG1 AI es el contrato que lo rodea: inferencia en nuestra infraestructura certificada HDS en Francia, cero retención de datos, ningún entrenamiento con tus prompts, facturación en euros y sin exposición a la jurisdicción estadounidense — a través del mismo endpoint compatible con OpenAI que el resto del catálogo, y sin ninguna ruta de datos hacia China.
1M tokens de entrada
0,65 €
1M de entrada en caché
0,13 €
1M tokens de salida
1,30 €
Contexto
1M tokens
Puntuaciones de la ficha oficial del modelo de DeepSeek (V4.1-Flash-1017, octubre de 2026), comparadas con modelos de frontera en los mismos benchmarks.
Frontera Eficiente
GLM 5.3 Flash. La Frontera Eficiente.
GLM 5.3 Flash es el modelo de frontera eficiente de IG1 AI API: un motor de razonamiento, programación y ejecución agéntica nativamente multimodal, con un contexto de un millón de tokens, ofrecido con inferencia soberana y precios transparentes por token.
Modelo
Posicionamiento
Ideal para
Ofrecido por IG1 AI
Modelo eficiente
MoE compacto
Cargas de producción de gran volumen
✓ Qwen 3.6 35B
Frontera eficiente
Eficiente
Razonamiento, código y agentes de clase mundial
✓ GLM 5.3 Flash
Frontera
Insignia open-weight
Razonamiento profundo, programación multiarchivo, agentes de largo horizonte
✓ DeepSeek V4.1 Flash
Lo que GLM 5.3 Flash cambia en la práctica
GLM 5.3 Flash está diseñado para tareas en las que la calidad, la precisión y la persistencia importan más que una respuesta genérica rápida. Aquí es donde la diferencia se nota de inmediato:
Análisis de contratos largos
GLM 5.3 Flash sigue referencias cruzadas, cláusulas anidadas, excepciones y definiciones a lo largo de documentos muy extensos — hasta un millón de tokens de contexto — y admite tanto texto como páginas escaneadas e imágenes.
Generación de código multiarchivo
Desde la planificación de la arquitectura hasta los detalles de implementación, GLM 5.3 Flash está optimizado para el desarrollo coherente multiarchivo, la refactorización y la depuración, con 63,4 en DeepSWE v1.1 en ingeniería de software autónoma.
Razonamiento con múltiples restricciones
Presupuesto, plazos, stack, conformidad, seguridad, UX, escalabilidad: GLM 5.3 Flash mantiene activas restricciones simultáneas y las convierte en decisiones claras.
Instrucciones complejas en contexto largo
Para prompts largos con requisitos anidados, GLM 5.3 Flash es el modelo a utilizar cuando tu equipo necesita que la respuesta se mantenga fiel a cada instrucción hasta el final de la generación.
¿Por qué elegir GLM 5.3 Flash?
Usa GLM 5.3 Flash cuando el trabajo es estratégico: razonamiento difícil, ideación de producto, programación avanzada, planificación agéntica, análisis profundo y documentos y medios donde los pequeños errores salen caros. Además, ofrece la mejor capacidad por euro del catálogo IG1 AI: la opción por defecto también para el trabajo diario.
Rendimiento de frontera, precios por token transparentes
GLM 5.3 Flash es el modelo de frontera eficiente del catálogo, con la mejor capacidad por euro: 0,35 € / 1M tokens de entrada (0,09 € en caché) y 1,15 € / 1M tokens de salida. Qwen 3.6 35B completa el catálogo para cargas de producción de gran volumen a 0,30 € (0,06 € en caché) / 1,00 €.
Modelo Eficiente
Qwen 3.6 35B. Eficiente, Listo para Producción.
DeepSeek V4.1 Flash es el modelo insignia y GLM 5.3 Flash la frontera eficiente. Qwen 3.6 35B es el nivel eficiente: un modelo Mixture-of-Experts diseñado para el tráfico de producción de gran volumen al precio por token más bajo del catálogo — disponible en tres perfiles: Instruct, Thinking y Thinking Coder.
Mixture-of-Experts disperso
Qwen 3.6 35B activa unos 3.000 millones de sus 35.000 millones de parámetros por token: respuestas rápidas y una huella de inferencia compacta, con un contexto de 256K tokens.
Diseñado para el tráfico de producción
A 0,30 € de entrada (0,06 € en caché) y 1,00 € de salida por 1M de tokens, Qwen 3.6 35B es el modelo más asequible del catálogo IG1 AI — diseñado para tráfico de producción, copilotos internos y pipelines de agentes de gran volumen.
Versatilidad de nivel de producción
Úsalo para chat, asistencia de programación, extracción estructurada, resúmenes y agentes que usan herramientas cuando no se requiere el razonamiento de nivel frontera.
Tres perfiles, un mismo precio
Instruct para respuestas rápidas del día a día, Thinking para el razonamiento estructurado, Thinking Coder para los flujos de trabajo de desarrollo — los tres a la misma tarifa de 0,30 € / 1,00 €, seleccionados en cada petición por ID de modelo, sin tocar tu presupuesto.
Caso de uso
Modelo recomendado
Por qué
Razonamiento profundo, programación multiarchivo, agentes de largo horizonte
Mejor capacidad por euro, contexto de 1M de tokens
Chat de producción, extracción, copilotos, agentes de gran volumen
Qwen 3.6 35B
Precio por token más bajo del catálogo
Razonamiento paso a paso y análisis
Qwen 3.6 35B Thinking
Modo de razonamiento forzado, mismo precio
Asistencia de programación y refactorización a gran volumen
Qwen 3.6 35B Thinking Coder
Ajustado para flujos de desarrollo, mismo precio
Enrutamiento híbrido
GLM + Qwen
GLM por defecto, Qwen donde encaja su perfil
Casos de Uso
¿Qué Significa Esto para Tu Equipo?
Todo tu equipo puede adoptar la IA — no solo tus ingenieros. Marketing, ventas, analistas, desarrolladores. IG1 AI API se adapta a donde estás.
Chat
Integra IA conversacional en cualquier aplicación. Crea asistentes inteligentes, bots de atención al cliente y flujos de trabajo interactivos.
Código
Lanza funcionalidades más rápido con el desarrollo asistido por IA. Genera, revisa, refactoriza y depura código a escala empresarial.
Resumir
Transforma miles de documentos en información accionable. Extrae, condensa y analiza el conocimiento empresarial a escala.
Crear
Genera contenido y análisis a escala. Desde textos de marketing hasta informes financieros, potencia cada departamento con la creación impulsada por IA.
Testimonio de cliente
EasyBourse: acelerar el desarrollo de software con IA soberana.
FINANZAS · DESARROLLO DE SOFTWARE
Un testimonio filmado: EasyBourse cuenta cómo la IA soberana ayuda a sus equipos a escalar el desarrollo de software.
La pregunta que toda empresa se hace. IG1 AI API está creada precisamente para esto. Tu equipo de seguridad dice que sí. Tu equipo legal dice que sí. Y puedes avanzar rápido con confianza.
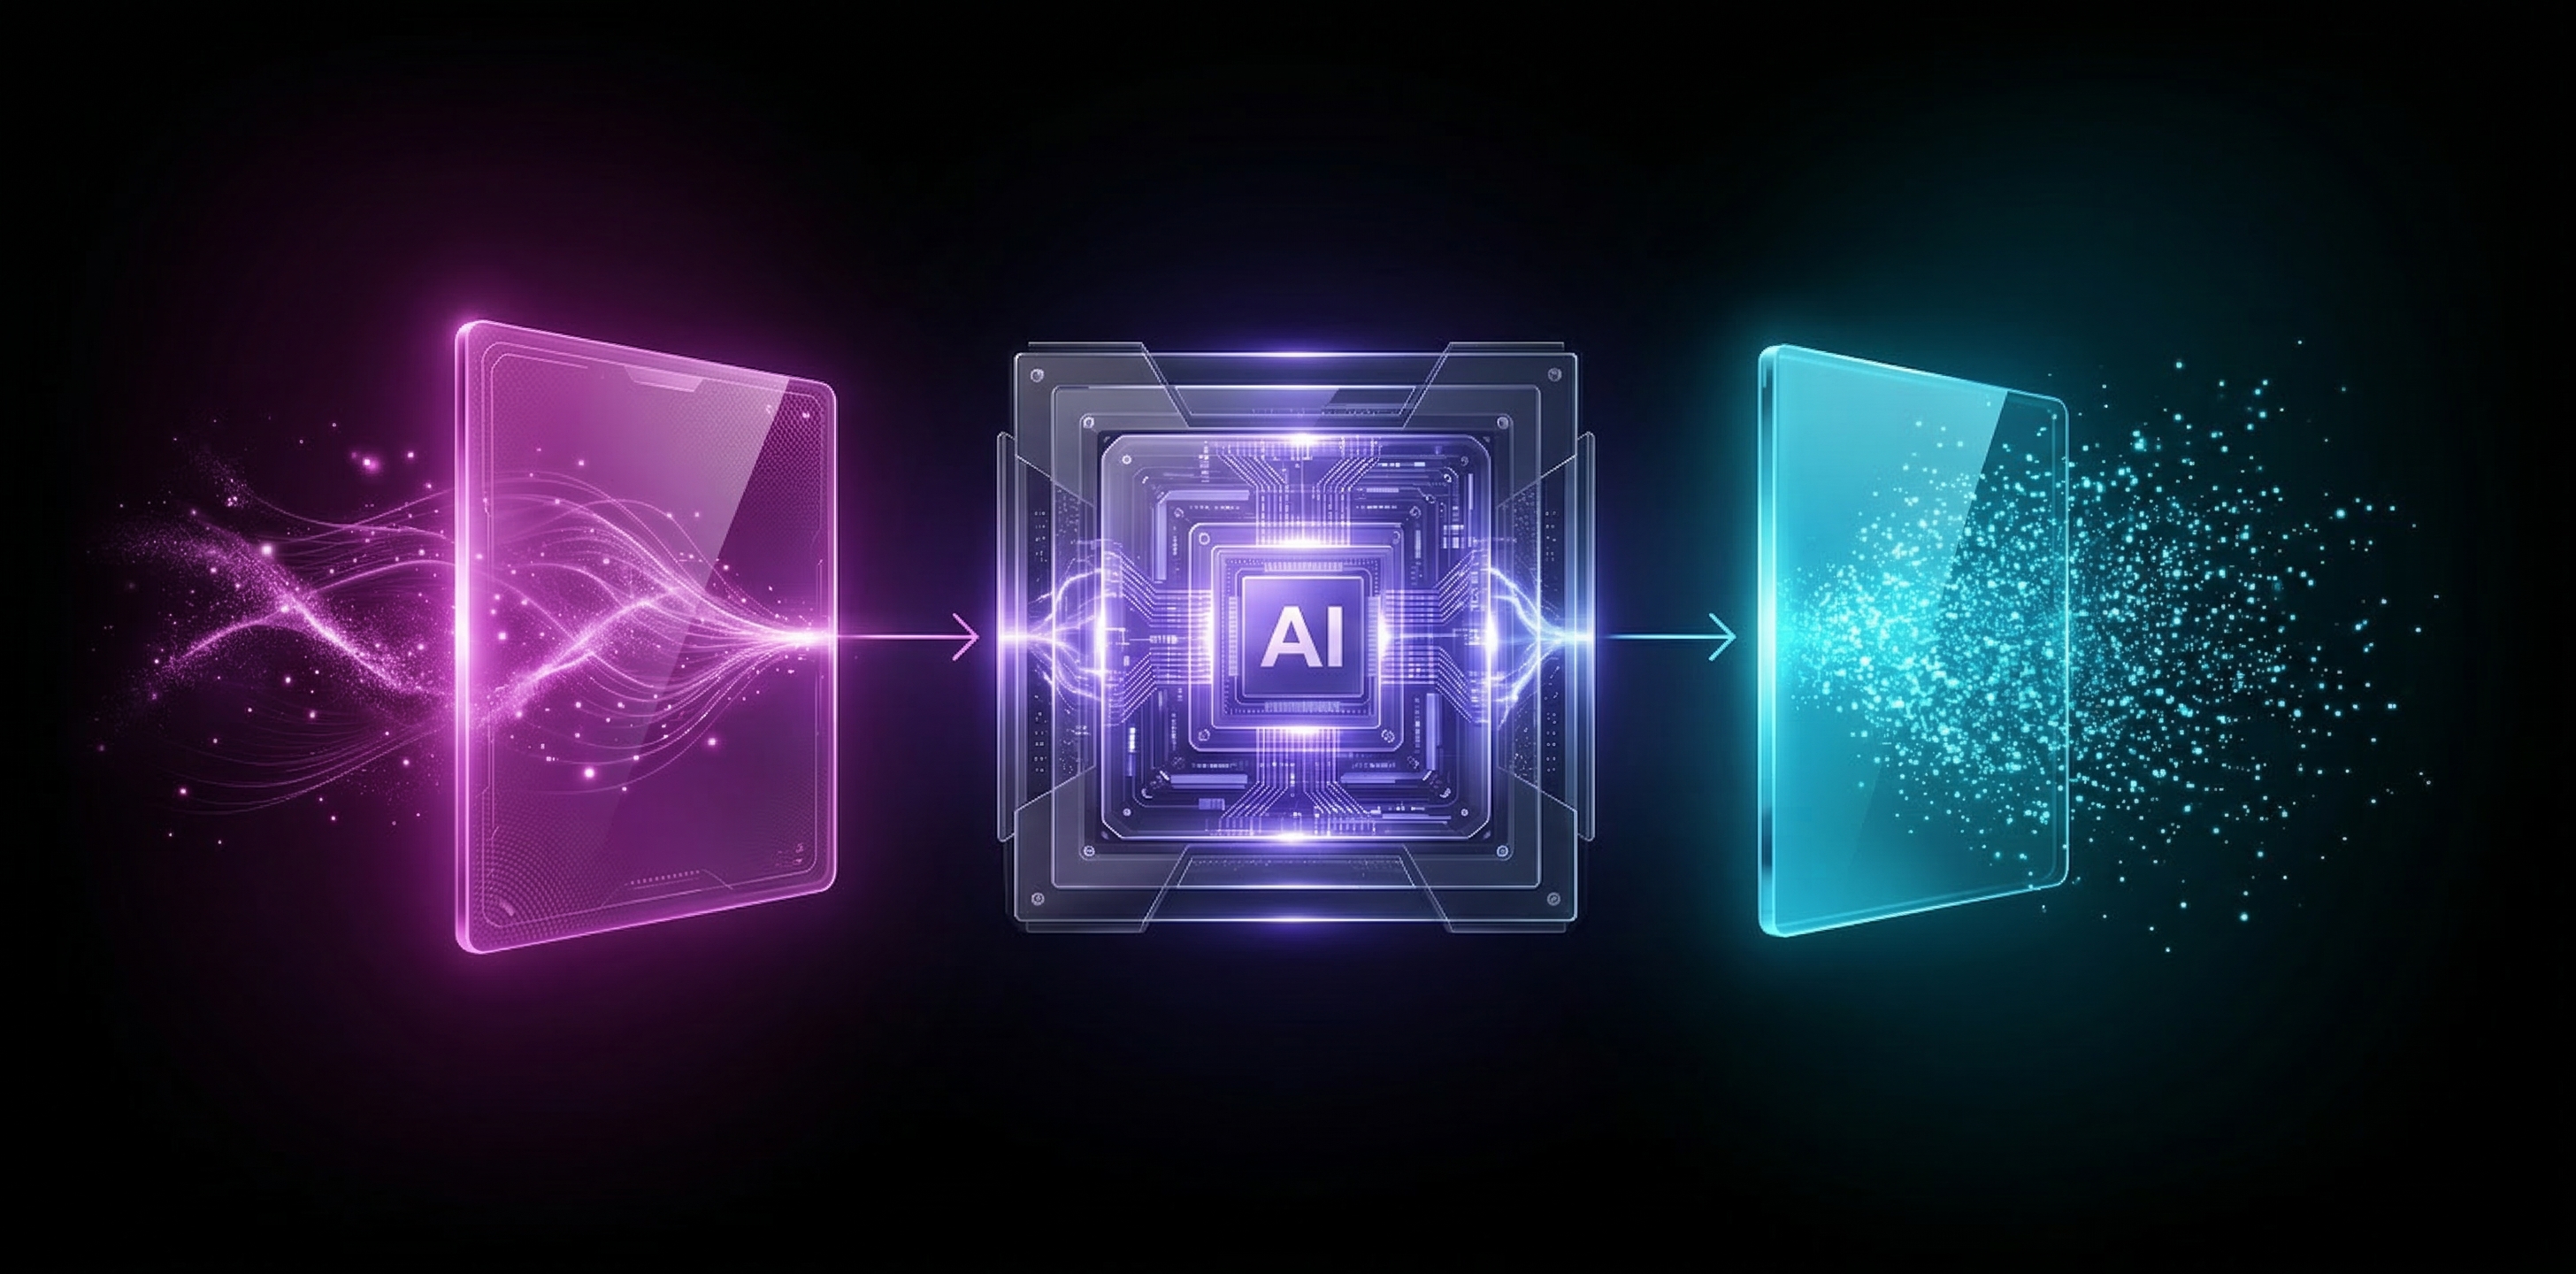
Cero Retención de Datos
Tus prompts se procesan y luego se borran de inmediato. Nada se almacena, nada se registra.
Sin Entrenamiento de Modelos
Nunca usamos tus datos para entrenar modelos. Tu propiedad intelectual te pertenece.
100% Soberano
Tus datos nunca salen de los límites de tu empresa. Plenamente conforme con RGPD, el Reglamento de IA de la UE y la ISO 27001.
Tu Prompt
IG1 AI Procesa
Borrado de Inmediato
Sin registros • Sin almacenamiento • Sin entrenamiento
Capacidades Avanzadas
No Solo Conformidad. Capacidad Real.
IG1 AI API está diseñada para ir más allá. IA de nivel empresarial creada para tu forma de trabajar.
Razonamiento Extendido
Razonamiento complejo de múltiples pasos para la resolución avanzada de problemas. Procesamiento de cadena de pensamiento para escenarios empresariales con matices — posible gracias al modelo de frontera eficiente GLM 5.3 Flash, donde los modelos más pequeños pierden coherencia a lo largo de cadenas de razonamiento extensas. Razonamiento profundo, plena soberanía, cero retención de datos.
Búsqueda Web y Uso de Herramientas
Búsqueda web en tiempo real integrada y flujos de trabajo conectados. Permite que tus agentes de IA interactúen con herramientas y fuentes de datos externas.
Uso Seguro del Ordenador
Ejecución de código y uso seguro del ordenador para una verdadera automatización agéntica. Permite que la IA opere de forma segura en entornos aislados (sandbox).
Modelos de Pesos Abiertos
Impulsada por los Mejores Modelos Abiertos.
Aprovechando los modelos de pesos abiertos más potentes disponibles hoy. Sin dependencia de proveedor. Transparencia total.
DeepSeek V4.1 Flash Nuevo
por DeepSeek — Hangzhou, China
LLM insignia
El modelo open-weight de frontera de DeepSeek (MoE de 552.000 millones de parámetros, 8.000 millones activos en prefill y 16.000 millones en decode) con comprensión nativa de texto e imagen, para razonamiento profundo, programación multiarchivo y agentes de largo horizonte.
GLM 5.3 Flash Frontera
por Z.ai — Pekín, China
LLM de frontera eficiente
Modelo de frontera eficiente para razonamiento, código y flujos de trabajo agénticos — con la mejor capacidad por euro.
Qwen 3.6
por Alibaba Cloud — Hangzhou, China
LLM 35B-A3B
Modelo eficiente Mixture-of-Experts para chat de producción, código, razonamiento y flujos de trabajo de gran volumen.
Qwen Image
por Alibaba Cloud — Hangzhou, China
Generación y Edición de Imágenes
Generación y edición de imágenes a partir de prompts de texto, con mejora opcional de prompts por LLM.
Qwen3-VL-Embedding-8B SOTA
por Alibaba Cloud — Hangzhou, China
Embedding Multimodal
Recuperación de última generación con embeddings multimodales y dimensiones dinámicas de hasta 4096 — mucho más allá de los codificadores de texto de tamaño fijo.
BGE
por BAAI — Pekín, China
Embedding y Reranking Rápidos
Embeddings de texto rápidos y de dimensión fija, y reranking — una referencia de calidad para búsqueda semántica y pipelines RAG de alto rendimiento.
Precios por Modelo
Nuestros Modelos
Precios transparentes por token. Todos los modelos son soberanos, alojados en Francia, sin tarifas ocultas y sin compromiso mínimo.
Modelos de Lenguaje
Modelo
Descripción
1M Tokens de Entrada
1M Tokens de Entrada en Caché
1M Tokens de Salida
DeepSeek V4.1 FlashNuevodeepseek-v4.1-flash
El modelo open-weight de frontera de DeepSeek (MoE de 552.000 millones de parámetros, 8.000 millones activos en prefill y 16.000 millones en decode) con comprensión nativa de texto e imagen, para razonamiento profundo, programación multiarchivo y agentes de largo horizonte. Contexto máximo: 1M de tokens. Servido con la versión 1017.
0,65 €
0,13 €
1,30 €
GLM-5.3-Flashglm53-flash-chat
Modelo de frontera eficiente nativamente multimodal (vídeo, imagen, texto, archivos) para el razonamiento, el código y los flujos de trabajo agénticos. Contexto máx.: 1M tokens, salida 128K. También disponible como glm53-flash-chat-low, glm53-flash-agent y glm53-flash-agent-low al mismo precio.
0,35 €
0,09 €
1,15 €
Qwen 3.6 35Bqwen36-35b-a3b-instruct
Modelo eficiente Mixture-of-Experts (35B parámetros, 3B activos) para chat de producción, código, extracción y flujos de trabajo multironda. Perfil instruct por defecto. Contexto máx.: 256K tokens.
Qwen 3.6 35B configurado para programación avanzada, refactorización, depuración y flujos de trabajo de desarrollo con razonamiento forzado.
0,30 €
0,06 €
1,00 €
BGE-m3
Embeddings de texto para RAG y búsqueda semántica.
0,05 €
N/A
N/A
BGE-reranker-v2-m3
Reranking para la optimización de resultados de búsqueda.
0,30 €
N/A
N/A
Qwen3-VL-Embedding-8B
Embeddings multimodales (texto e imágenes) para RAG y búsqueda semántica visual.
0,30 €
N/A
N/A
Document
Convierte cualquier documento a Markdown para ser usado por un LLM. Útil para CAG – RAG en caché, incluidos casos de uso de RAG con visión. Las imágenes de documentos se describen como texto mediante Qwen 3.6 35B.
N/A
N/A
2,00 €
Por qué los tokens de entrada en caché le hacen ahorrar
Cuando un agente de IA trabaja en una tarea — revisar código, corregir un error en varios archivos, mantener una conversación larga — envía una y otra vez el mismo contexto: sus instrucciones, los archivos con los que trabaja, todo lo dicho hasta ahora. Solo una pequeña parte es realmente nueva en cada llamada.
Con la caché de entrada, IG1 AI conserva lo que ya ha leído y procesa solo lo nuevo. Las respuestas empiezan antes y el contexto repetido se factura a la tarifa de entrada en caché: alrededor de una cuarta parte del precio de entrada normal en GLM 5.3 Flash (0,09 € frente a 0,35 €) y una quinta parte en Qwen 3.6 35B (0,06 € frente a 0,30 €) y en DeepSeek V4.1 Flash (0,13 € frente a 0,65 €).
Ejemplo — una sesión de programación agéntica con GLM 5.3 Flash: 100 llamadas a la API, ~20.000 tokens de contexto reenviados en cada llamada, 65 % de aciertos de caché.
Sin caché
Con caché
Tokens de entrada a tarifa completa
2,0 M
0,7 M
Tokens de entrada a tarifa de caché
—
1,3 M
Coste de entrada
0,70 €
0,36 €
Total de la sesión (incl. 25K tokens de salida)
0,73 €
0,39 €
−48 % en el coste de entrada, −46 % en la sesión — y un primer token más rápido.
La caché es automática en todos los modelos de lenguaje de IG1 AI — no hay nada que configurar. El detalle de uso de cada respuesta indica exactamente cuántos tokens de entrada se sirvieron desde la caché.
Modelos de Imagen
Modelo
Descripción
1M Tokens de Entrada
1M Tokens de Salida
Qwen Image
Generación de imágenes. El recuento de tokens se basa en la resolución y el nivel de calidad de la imagen.
0 €
0,002 €
Qwen Image PE
Generación de imágenes con mejora de prompts por LLM. La mejora de prompts usa Qwen 3.6 35B (se factura por separado). El recuento de tokens se basa en la resolución y el nivel de calidad.
0 €
0,002 €
Qwen Image Edit
Edición de imágenes. El recuento de tokens se basa en la resolución y el nivel de calidad de la imagen de origen y de la generada.
0 €
0,002 €
Qwen Image Edit PE
Edición de imágenes con mejora de prompts por LLM. La mejora de prompts usa Qwen 3.6 35B (se factura por separado). El recuento de tokens se basa en la resolución y la calidad de la imagen de origen y de la generada.
0 €
0,002 €
Precios
Rendimiento de Clase Mundial. 3× Menos Coste.
Hasta 3 veces más barato que los hyperscalers estadounidenses. Con IG1 AI API, no hay infraestructura que configurar. Las aplicaciones se conectan al instante y el ahorro de costes empieza desde el primer día.
Todo lo que necesitas saber sobre IG1 AI API — soberanía, modelos, precios y cómo empezar.
Soberanía y Seguridad
¿Dónde se alojan mis datos?
Exclusivamente en las propias instalaciones de IG1 en Francia, sobre hardware de Dell Technologies y NVIDIA. Tus datos nunca salen de nuestra infraestructura europea.
¿Retenéis o usáis mis datos para entrenar modelos?
No. Cero retención de datos. Cero entrenamiento con datos. Cero intercambio de datos. Cuando tu solicitud se procesa, desaparece. Punto.
¿IG1 AI cumple con el RGPD?
Sí. También con la ISO 27001 y el Reglamento de IA de la UE. Nuestra arquitectura soberana, alojada en la UE, con estrictas garantías de cero retención de datos, está diseñada para la conformidad por defecto.
¿En qué se diferencia esto de usar ChatGPT, Claude o Gemini?
OpenAI, Anthropic y Google son empresas estadounidenses sujetas a la jurisdicción de EE. UU. (incluida la CLOUD Act). Tus datos transitan y pueden almacenarse en infraestructura estadounidense. Con IG1 AI, tus datos permanecen en Francia, bajo la legislación europea, con cero retención, cero intercambio de datos y cero entrenamiento con datos.
Modelos y Rendimiento
¿Qué modelos usa IG1 AI?
Ejecutamos los mejores modelos de pesos abiertos disponibles, encabezados por DeepSeek V4.1 Flash — el modelo insignia del catálogo de IG1 AI — y GLM 5.3 Flash para razonamiento, programación y flujos de trabajo agénticos de frontera. El catálogo también incluye Qwen 3.6 35B para tareas de lenguaje eficientes y de gran volumen, Qwen3-VL-Embedding-8B y BGE para embeddings y reranking, y Qwen Image para la generación visual.
¿Puedo elegir qué modelo usar?
Sí. Elige DeepSeek V4.1 Flash — el modelo más capaz del catálogo — para razonamiento profundo, programación multiarchivo y agentes de largo horizonte, GLM 5.3 Flash para razonamiento y programación de frontera con la mejor capacidad por euro, Qwen 3.6 35B (Instruct, Thinking o Thinking Coder) para cargas de producción de gran volumen al precio por token más bajo, o los modelos dedicados de embedding y reranking Qwen3-VL-Embedding-8B / BGE y Qwen Image para tareas especializadas.
¿Vuestros modelos están cuantizados?
Sí — de forma deliberada, y elegida para preservar la calidad. Cuando existe una versión de mayor precisión (p. ej. Qwen), servimos FP8: el impacto en la calidad es insignificante mientras que la memoria de GPU y el coste se reducen aproximadamente a la mitad, lo que constituye la decisión de ingeniería correcta. Cuando un modelo de frontera solo se publica cuantizado, lo servimos en su precisión nativa. Lo que nunca hacemos es aplicar una cuantización agresiva de bajos bits que degradaría las tareas más difíciles (razonamiento de múltiples pasos, análisis de documentos complejos, generación de código a gran escala). Las cifras de los benchmarks que publicamos reflejan la precisión exacta que servimos en producción.
Precios y Facturación
¿Cómo funcionan los precios?
Dos partes. Una suscripción plana de 100 € / mes que incluye 100 € de uso en todos los modelos del catálogo. A partir de ahí, el uso se factura según las tarifas por token publicadas (GLM 5.3 Flash a 0,35 € de entrada, 0,09 € de entrada en caché y 1,15 € de salida; Qwen 3.6 35B a 0,30 € de entrada, 0,06 € de entrada en caché y 1,00 € de salida), hasta un límite mensual de 1 000 € con la suscripción de 100 € (el límite se ajusta a tu plan). Sin tarifas ocultas. DeepSeek V4.1 Flash se factura a 0,65 € de entrada, 0,13 € de entrada en caché y 1,30 € de salida. El contexto reenviado entre llamadas se factura a la tarifa de entrada en caché — consulte Por qué los tokens de entrada en caché le hacen ahorrar.
¿Qué pasa si alcanzo mi límite?
Tu límite mensual es de 1 000 € con la suscripción de 100 €, y aumenta con los planes superiores. Cuando lo alcanzas, el acceso se pausa hasta el siguiente ciclo de facturación — o hasta que pagues ese importe. Nunca se te cobra más allá del límite que tú controlas. Si lo alcanzas de forma recurrente, hablaremos de elevar tu límite.
¿Cómo se factura el exceso de uso?
El día 1 de cada mes facturamos el exceso del mes anterior — el uso por encima de tu cuota incluida — junto con la suscripción del mes que comienza. El pago se realiza por domiciliación SEPA o tarjeta guardada.
¿Por qué una suscripción más uso facturado?
Obtienes la previsibilidad de una base mensual fija y la flexibilidad de escalar cuando un proyecto lo exige — sin renegociación. Los meses tranquilos siguen siendo ligeros, los meses intensos siguen estando limitados. Solo pagas por lo que usas, hasta un límite que tú estableces.
¿Puedo contratar un plan superior?
Sí. Hay suscripciones mensuales superiores — con una cuota incluida y un límite más altos — disponibles para los equipos que necesitan más. Contacta con ventas para establecer un compromiso adaptado a tu volumen.
¿Hay una prueba gratuita?
Contáctanos para conocer las opciones de programa piloto.
Cómo Empezar
¿Cuánto tarda la configuración?
Cero configuración de infraestructura por tu parte. Puedes estar operativo el mismo día.
¿Necesito un equipo técnico para usar IG1 AI?
No. IG1 AI está diseñado para todos los equipos — marketing, ventas, RR. HH., legal, analistas y desarrolladores. Si sabes usar una interfaz de chat, sabes usar IG1 AI.
¿Puedo integrar IG1 AI en mis herramientas existentes?
Sí. IG1 AI ofrece acceso a la API compatible con aplicaciones de chat de IA estándar (Msty, Open WebUI) e integraciones de IDE para desarrolladores. Conecta tus flujos de trabajo existentes sin cambiar de herramientas.
¿Y si aparece una plataforma de IA mejor?
Sin dependencia. La facturación mensual sin compromiso significa que puedes irte cuando quieras. Pero como actualizamos continuamente a los mejores modelos de pesos abiertos, siempre estás en la frontera sin tener que cambiar.
SOCIOS TECNOLÓGICOS
Impulsada por Líderes del Sector
Nos asociamos con los principales proveedores tecnológicos del mundo para ofrecer una infraestructura de IA soberana y de nivel empresarial.
NVIDIA
Socio de infraestructura de GPU que impulsa nuestras cargas de trabajo de inferencia y entrenamiento de IA. La computación acelerada de NVIDIA permite servir modelos en tiempo real con un rendimiento inigualable.
Dell Technologies
Socio de servidores y almacenamiento empresarial que aporta la columna vertebral de hardware on-premise para los despliegues de IA soberana — seguro, escalable y diseñado para producción.
En 2026, la IA Ya No Es una Ventaja Competitiva. Es el Punto de Partida.
Todo el mundo tiene acceso a los modelos. La verdadera pregunta es: ¿construyes más rápido? ¿Construyes de forma más inteligente? Tus competidores ya lo hacen.